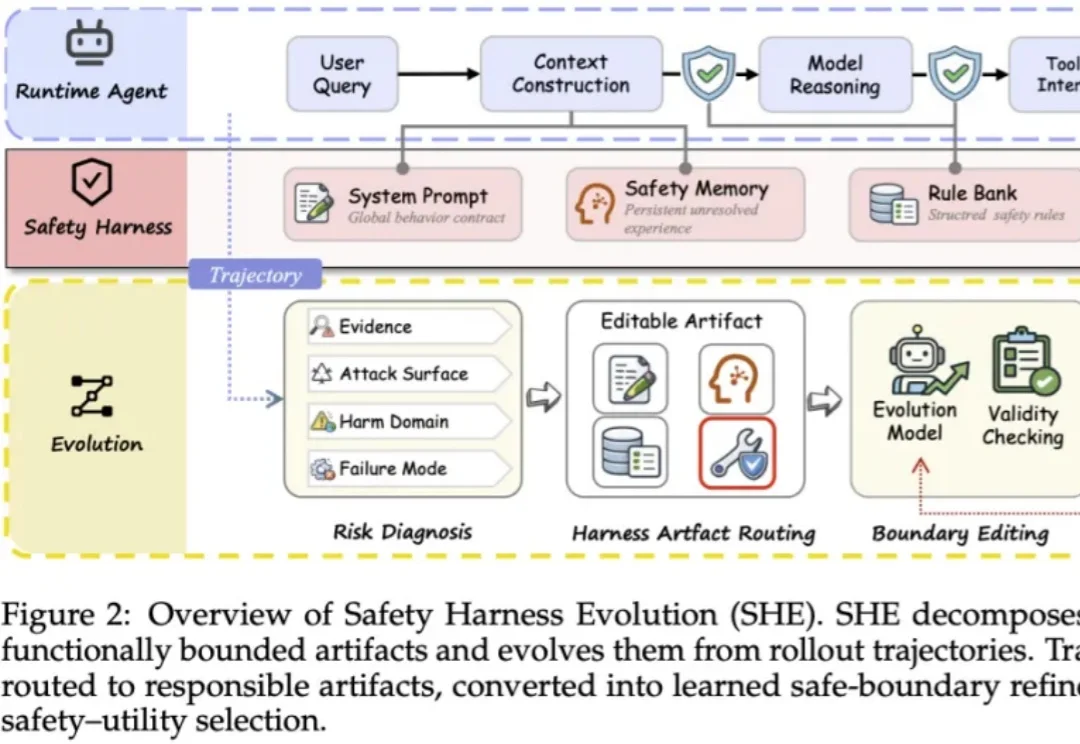
AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式
AI Agent安全不能只靠Prompt了:上海AI Lab探索Agent安全进化新范式大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
来自主题: AI技术研报
7844 点击 2026-09-17 14:55

 搜索
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
当 AI Agent 开始连续数小时替人工作,真正有价值的就不只是最终成果,还有藏在会话(Session)里的整个过程:它做过什么、哪里失败、为何改变方向。
在过去的几年里,LLM RL 系统的工作负载发生了巨大的变化。早期的 RLHF 围绕同步训练展开:模型按固定顺序进行生成、打分和训练,每个阶段之间有着明确的同步边界。如今,系统还需要处理异步生成、持续训练、多轮 Agent 以及与外部环境的交互 —— 那些在同步执行中原本隐含的状态、版本和故障边界,现在都必须显式地进行管理。
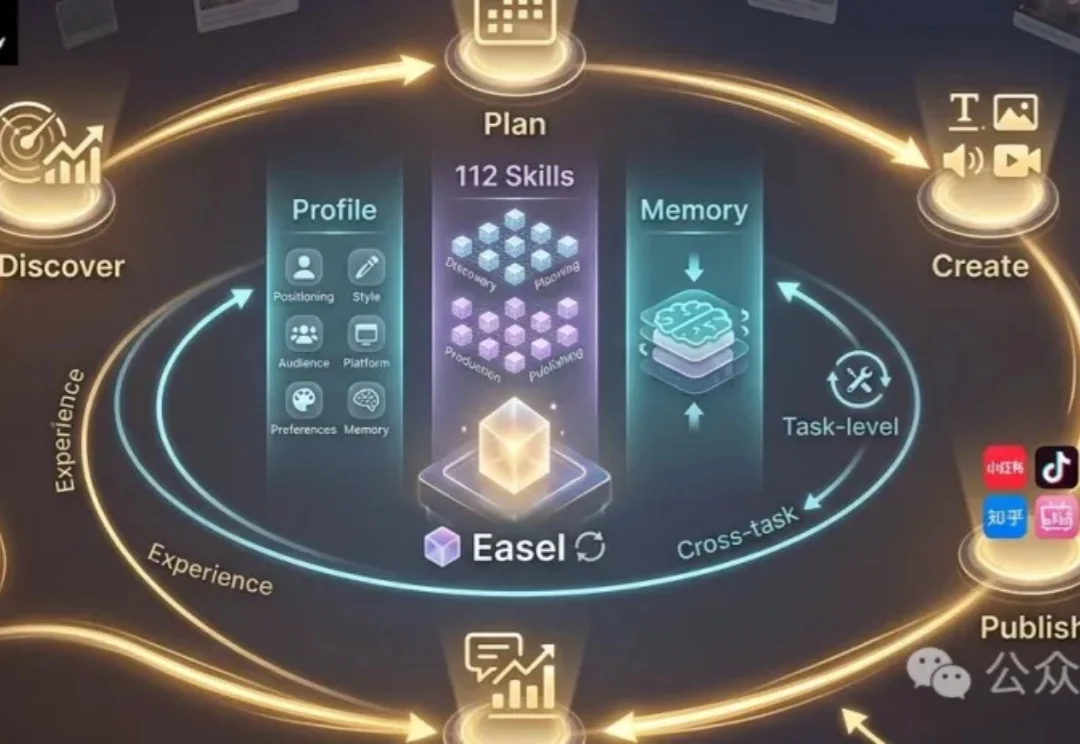
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
一个 Agent 第一次没把任务做对。
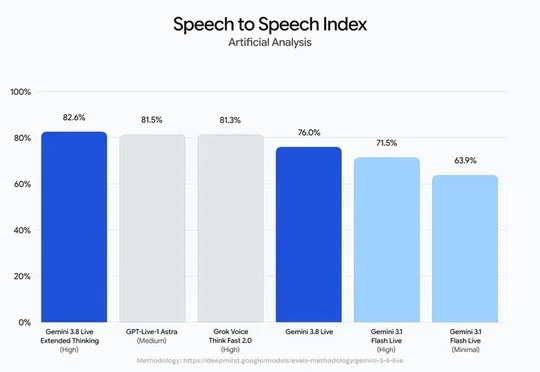
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款实时语音模型,后者支持后台异步推理与工具调用以解决语音 Agent 在任务执行中的沉默问题,两款模型已在 Gemini API 和 Google AI Studio 向开发者开放。
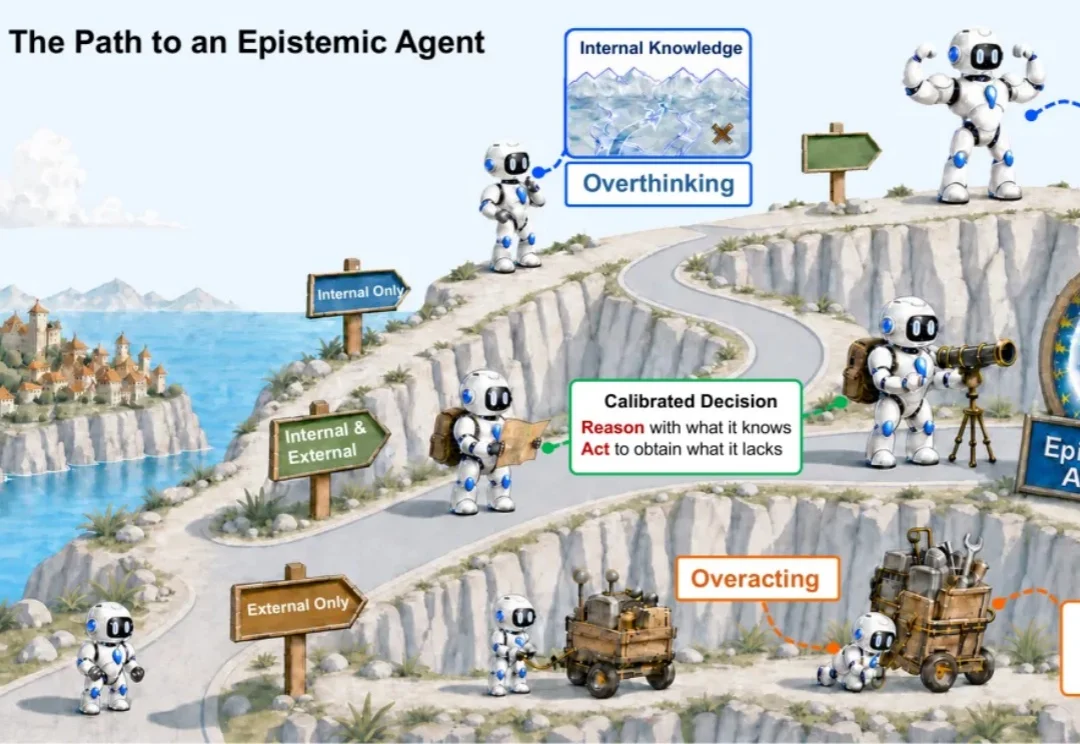
北航、南方科技大学、复旦大学、北京理工大学、爱丁堡大学等 8 家机构的 19 位研究者联合完成 Theory of Agent 综述,讨论模型内部与外部 harness 应如何分配能力,并据此梳理 LLM Agent 的学习、对齐、演化与评测。
OpenAI Codex团队主张模型越强Harness应越轻量,Anthropic Claude Code团队则认为模型越强Harness反而需越复杂以支撑Agent长时间自主运行,两者共同揭示了Agent Harness正经历从辅助层向承重结构转变的结构性变化。

实测显示,中国联通元景数字员工基于自研Agent Harness架构,具备全渠道触达与超千项技能,在深度研究、全时助理等办公场景中表现稳定可靠,并已在政务、工业、文旅等领域实现行业落地。
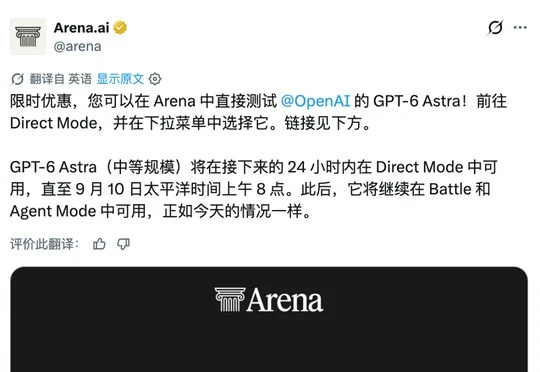
AI大模型评测平台Arena宣布用户可在直接模式中限时免费使用GPT-6 Astra(仅限medium级别),大量开发者涌入体验开发游戏,目前该模型在Agent Arena榜单中整体排名第二、前端网页开发排名第一。